前言
如果让机器人认识这个世界,第一步是什么?
答案是:看见。
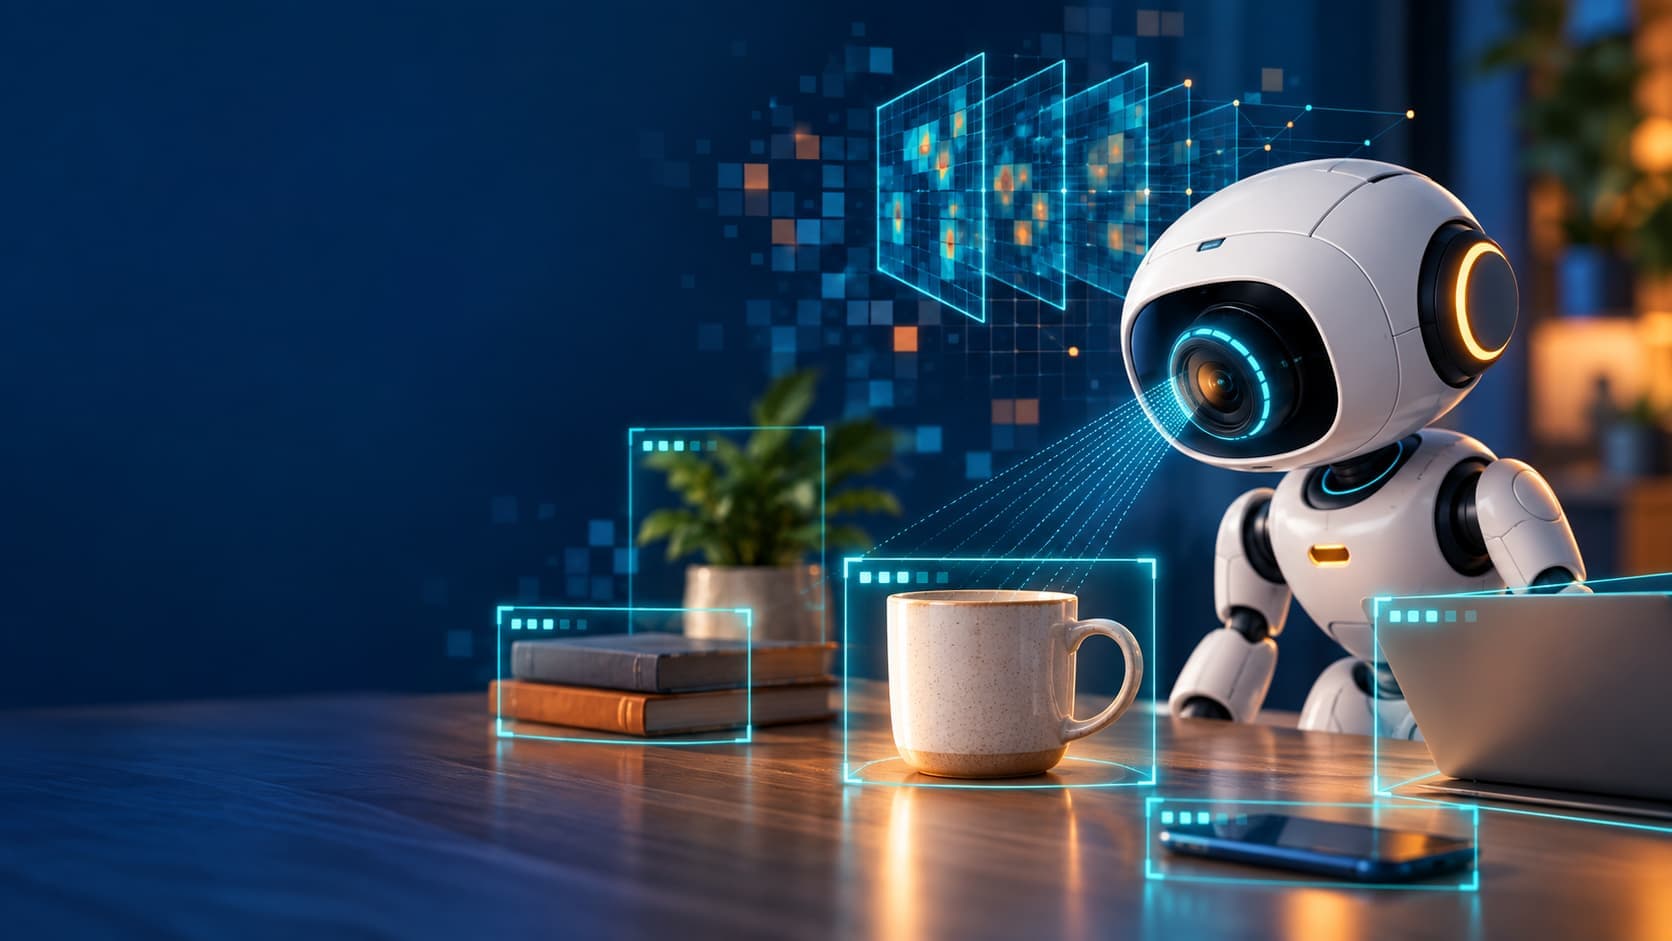
人类通过眼睛获取信息,大脑分析理解,再决定如何行动。而机器人也是一样,它需要通过摄像头获取图像,再利用人工智能算法识别环境中的物体。
机器人看到桌面上的一个杯子,它需要知道:
- 这是什么?
- 它在哪里?
- 应该如何抓取?
其中第一步“看见”,就是计算机视觉要解决的问题。在计算机视觉领域,有一个非常经典的算法——YOLO(You Only Look Once)。它被广泛应用于自动驾驶、机器人、智能监控、工业检测等领域,是目前最流行的目标检测算法之一。用于目标检测、实例分割、语义分割、深度估计、分类、姿态估计、定向边界框和跟踪,可通过一个 Python 包和命令行界面 (CLI) 使用。 文档
什么是目标检测?
在介绍YOLO之前,需要先理解什么是目标检测。
计算机看到一张图片时,本质上只是一堆数字,如一张640×640的图片,实际上包含大量像素信息,但是计算机并不知道:
- 图片里有没有人?
- 哪个区域是汽车?
- 哪个位置是动物?
目标检测就是让计算机同时完成两件事:
- 识别图片中的目标是什么。(这是一个人,这是汽车)
- 找到目标的位置。(这个人的位置在图片左侧,汽车位于图片中央)
因此,目标检测实际上包含分类 + 定位两个任务。
YOLO如何识别目标?
YOLO的核心思想是:把目标检测看成一个回归问题。
简单来说,就是让神经网络直接预测目标的位置和类别,YOLO会先把图片划分成很多小区域,也就是网格。如一张图片被划分成7×7个区域,然后每个区域负责检测“如果目标中心点落在我的区域,我负责预测它。”
比如:一辆汽车在图片中间,那么包含汽车中心点的网格就会负责预测汽车。
网络会输出几个重要信息:
第一:目标的位置。
- 中心点坐标
- 宽度
- 高度
第二:
目标的类别。
- 人
- 汽车
- 狗
- 杯子
第三:
- 置信度(我认为这里有目标的概率是多少)
最终YOLO输出类似:这里有一辆汽车,概率95%,位置在图片中央。
YOLO的网络结构
YOLO本质上也是一个深度学习模型,它主要由三个部分组成:
Backbone(骨干网络),负责提取图片特征。
比如:
- 低层特征: 边缘、颜色、纹理
- 高层特征:物体形状、语义信息
简单理解:Backbone就是机器人的“视觉神经”。
Neck(特征融合),负责融合不同层的信息。
为什么需要融合?因为图片中的目标大小不同。
例如:远处的小汽车和近处的大汽车。
模型需要同时看到细节信息和整体信息,所以Neck会把不同尺度的特征结合起来。
Detection Head(检测头),负责最终输出结果:
- 目标类别
- 目标位置
- 置信度
也就是告诉我们“图片里面有什么,以及在哪里。”
YOLO工程实践:从安装到模型预测
理解YOLO的原理之后,我们可以实际运行一个YOLO模型。
一个完整的目标检测流程通常包括:
- 安装YOLO环境
- 准备数据集
- 训练模型
- 验证模型效果
- 使用模型进行预测
- 部署到实际应用
YOLO安装
YOLO目前最常用的工程实现是 Ultralytics YOLO,它将模型训练、验证、预测、部署等功能进行了封装,只需要通过简单的Python接口即可完成目标检测任务,当然现在都是采用AI进行部署,这里讲解下流程,实际开发过程中AI会后台部署。
首先安装Ultralytics:
pip install ultralytics
安装完成后,可以通过以下代码检查环境:
import ultralytics

ultralytics.checks()
如果安装成功,会显示当前:
- Python版本
- PyTorch版本
- GPU信息
- CUDA环境
对于机器人、自动驾驶等实时视觉任务,通常建议使用GPU进行训练和推理。
YOLO模型加载
YOLO提供了不同规模的模型,例如:
yolo11n.pt   # nano,速度最快
yolo11s.pt   # small
yolo11m.pt   # medium
yolo11l.pt   # large
yolo11x.pt   # 最大模型
模型大小的优点,精度更高。缺点是推理速度更慢,占用显存更多。在机器人端部署时,通常会选择nano、small这种轻量模型。
加载模型:
from ultralytics import YOLO


# 加载预训练模型
model = YOLO("yolo11n.pt")
这里加载的是已经在COCO数据集上训练好的模型,COCO数据集包含:人、汽车、动物、家具、日常用品等80种常见类别。
YOLO模型训练
如果想让YOLO识别自己的目标,例如:
机器人识别:特定零件、工业产品、实验设备就需要使用自己的数据集进行训练。
训练流程:
采集图片
↓
人工标注
↓
生成数据集
↓
训练YOLO模型
↓
测试模型效果
数据集准备
YOLO的数据标注格式非常简单,每张图片对应一个txt文件。
- 图片:
robot.jpg - 对应标签:
robot.txt - 内容:
0 0.52 0.43 0.25 0.30
分别表示:
类别ID
目标中心x
目标中心y
目标宽度
目标高度
这些坐标都是经过归一化处理的。
例如0.5,表示图片宽度或者高度的50%位置。
开始训练
训练代码:
from ultralytics import YOLO


# 加载预训练模型
model = YOLO("yolo11n.pt")


# 开始训练
results = model.train(
    data="dataset.yaml",
    epochs=100,
    imgsz=640,
    device=0
)
参数含义:
data
指定数据集配置文件。
例如:
train: images/train
val: images/val


names:
  0: cup
  1: robot
告诉模型训练图片在哪里,有哪些类别。
epochs
训练轮数。
例如:
epochs=100
表示模型完整学习数据集100次。
imgsz
输入图片大小常用:
640×640
device
训练设备如:
device=0
表示使用第一块GPU。
如果没有GPU为:
device="cpu"
则采用CPU训练。
YOLO模型验证
训练完成后,需要验证模型效果。因为训练准确率高,并不代表模型真正具有检测能力。
验证主要关注几个指标:
Precision(精确率)
表示预测出来的目标,有多少是真的。
例如:
模型检测10辆汽车,其中9辆是真汽车。
Precision:90%
Recall(召回率)
表示真实目标中,有多少被发现。
例如: 图片中有10辆汽车,模型找到9辆。
Recall:90%
mAP(平均精度)
目标检测中最重要指标之一。
它综合考虑:
- 分类准确性
- 位置准确性
通常:
mAP越高,模型效果越好。
验证代码:
from ultralytics import YOLO


model = YOLO("best.pt")


results = model.val(
    data="dataset.yaml"
)


print(results)
训练完成后:
best.pt
通常就是效果最好的模型权重。
YOLO模型预测
预测是实际应用中最常用的功能。
例如:
机器人摄像头获取图片:
↓
YOLO识别目标
↓
返回目标位置
代码:
from ultralytics import YOLO


model = YOLO("best.pt")


results = model.predict(
    source="test.jpg",
    conf=0.5
)


for result in results:
    result.show()
其中:
source
表示输入,可以是:
- 图片
- 视频
- 摄像头
例如图片:
source="test.jpg"
视频:
source="video.mp4"
摄像头:
source=0
YOLO实时检测
机器人通常需要实时视觉。例如机械臂摄像头持续观察环境,可以直接调用摄像头:
model.predict(
    source=0,
    show=True
)
运行后摄像头画面会实时显示:
person 0.95

cup 0.91

chair 0.88
这就是机器人视觉系统最基础的能力。
YOLO模型部署
训练好的模型还可以部署到不同平台。常见部署方式:
ONNX
适合:
- 跨平台部署
- 工业电脑
导出:
model.export(format="onnx")
TensorRT
适合:
- NVIDIA GPU
- 自动驾驶
- 机器人实时推理
导出:
model.export(format="engine")
边缘设备
例如:
- NVIDIA Jetson
- 工业机器人控制器
通过模型压缩:
- 减少参数
- 降低计算量
实现实时运行。
一个完整机器人视觉流程
在机器人系统中,YOLO通常位于感知层:
摄像头
↓
YOLO目标检测
↓
目标位置计算
↓
路径规划
↓
运动控制
↓
机械执行
例如:机器人抓取水杯
摄像头看到桌面。
↓
YOLO检测:cup,x=320,y=240
↓
机器人计算杯子的三维位置。
↓
机械臂规划运动。
↓
完成抓取。
YOLO负责的是:让机器人知道“有什么,以及在哪里”。
总结
YOLO最大的贡献,是改变了目标检测的方式,过去计算机需要先寻找目标,再判断目标是什么。而YOLO直接从整张图片中预测目标,它让目标检测从复杂流程变成了一次快速推理。
如今,在机器人、自动驾驶、智能制造等领域,YOLO仍然是视觉感知的重要基础,未来的机器人想要真正进入现实世界,需要的不仅是看到物体,还需要理解环境、规划任务并完成行动。
YOLO,就是机器人拥有“眼睛”的第一步。